 Luis Brancher
Testando o restore do meu homelab: Postgres, Google Drive e rate limit
A segunda parte da revisão do homelab: dump antes do snapshot, um restore que falhou duas vezes, a cópia criptografada no Google Drive, um rate limit que reenviava 57GiB e um mapa para ver o que ainda não foi testado.
No post anterior mexi nos discos. Agora vem o backup, onde a revisão me surpreendeu: eu achava que tinha cópia de tudo, e não tinha.
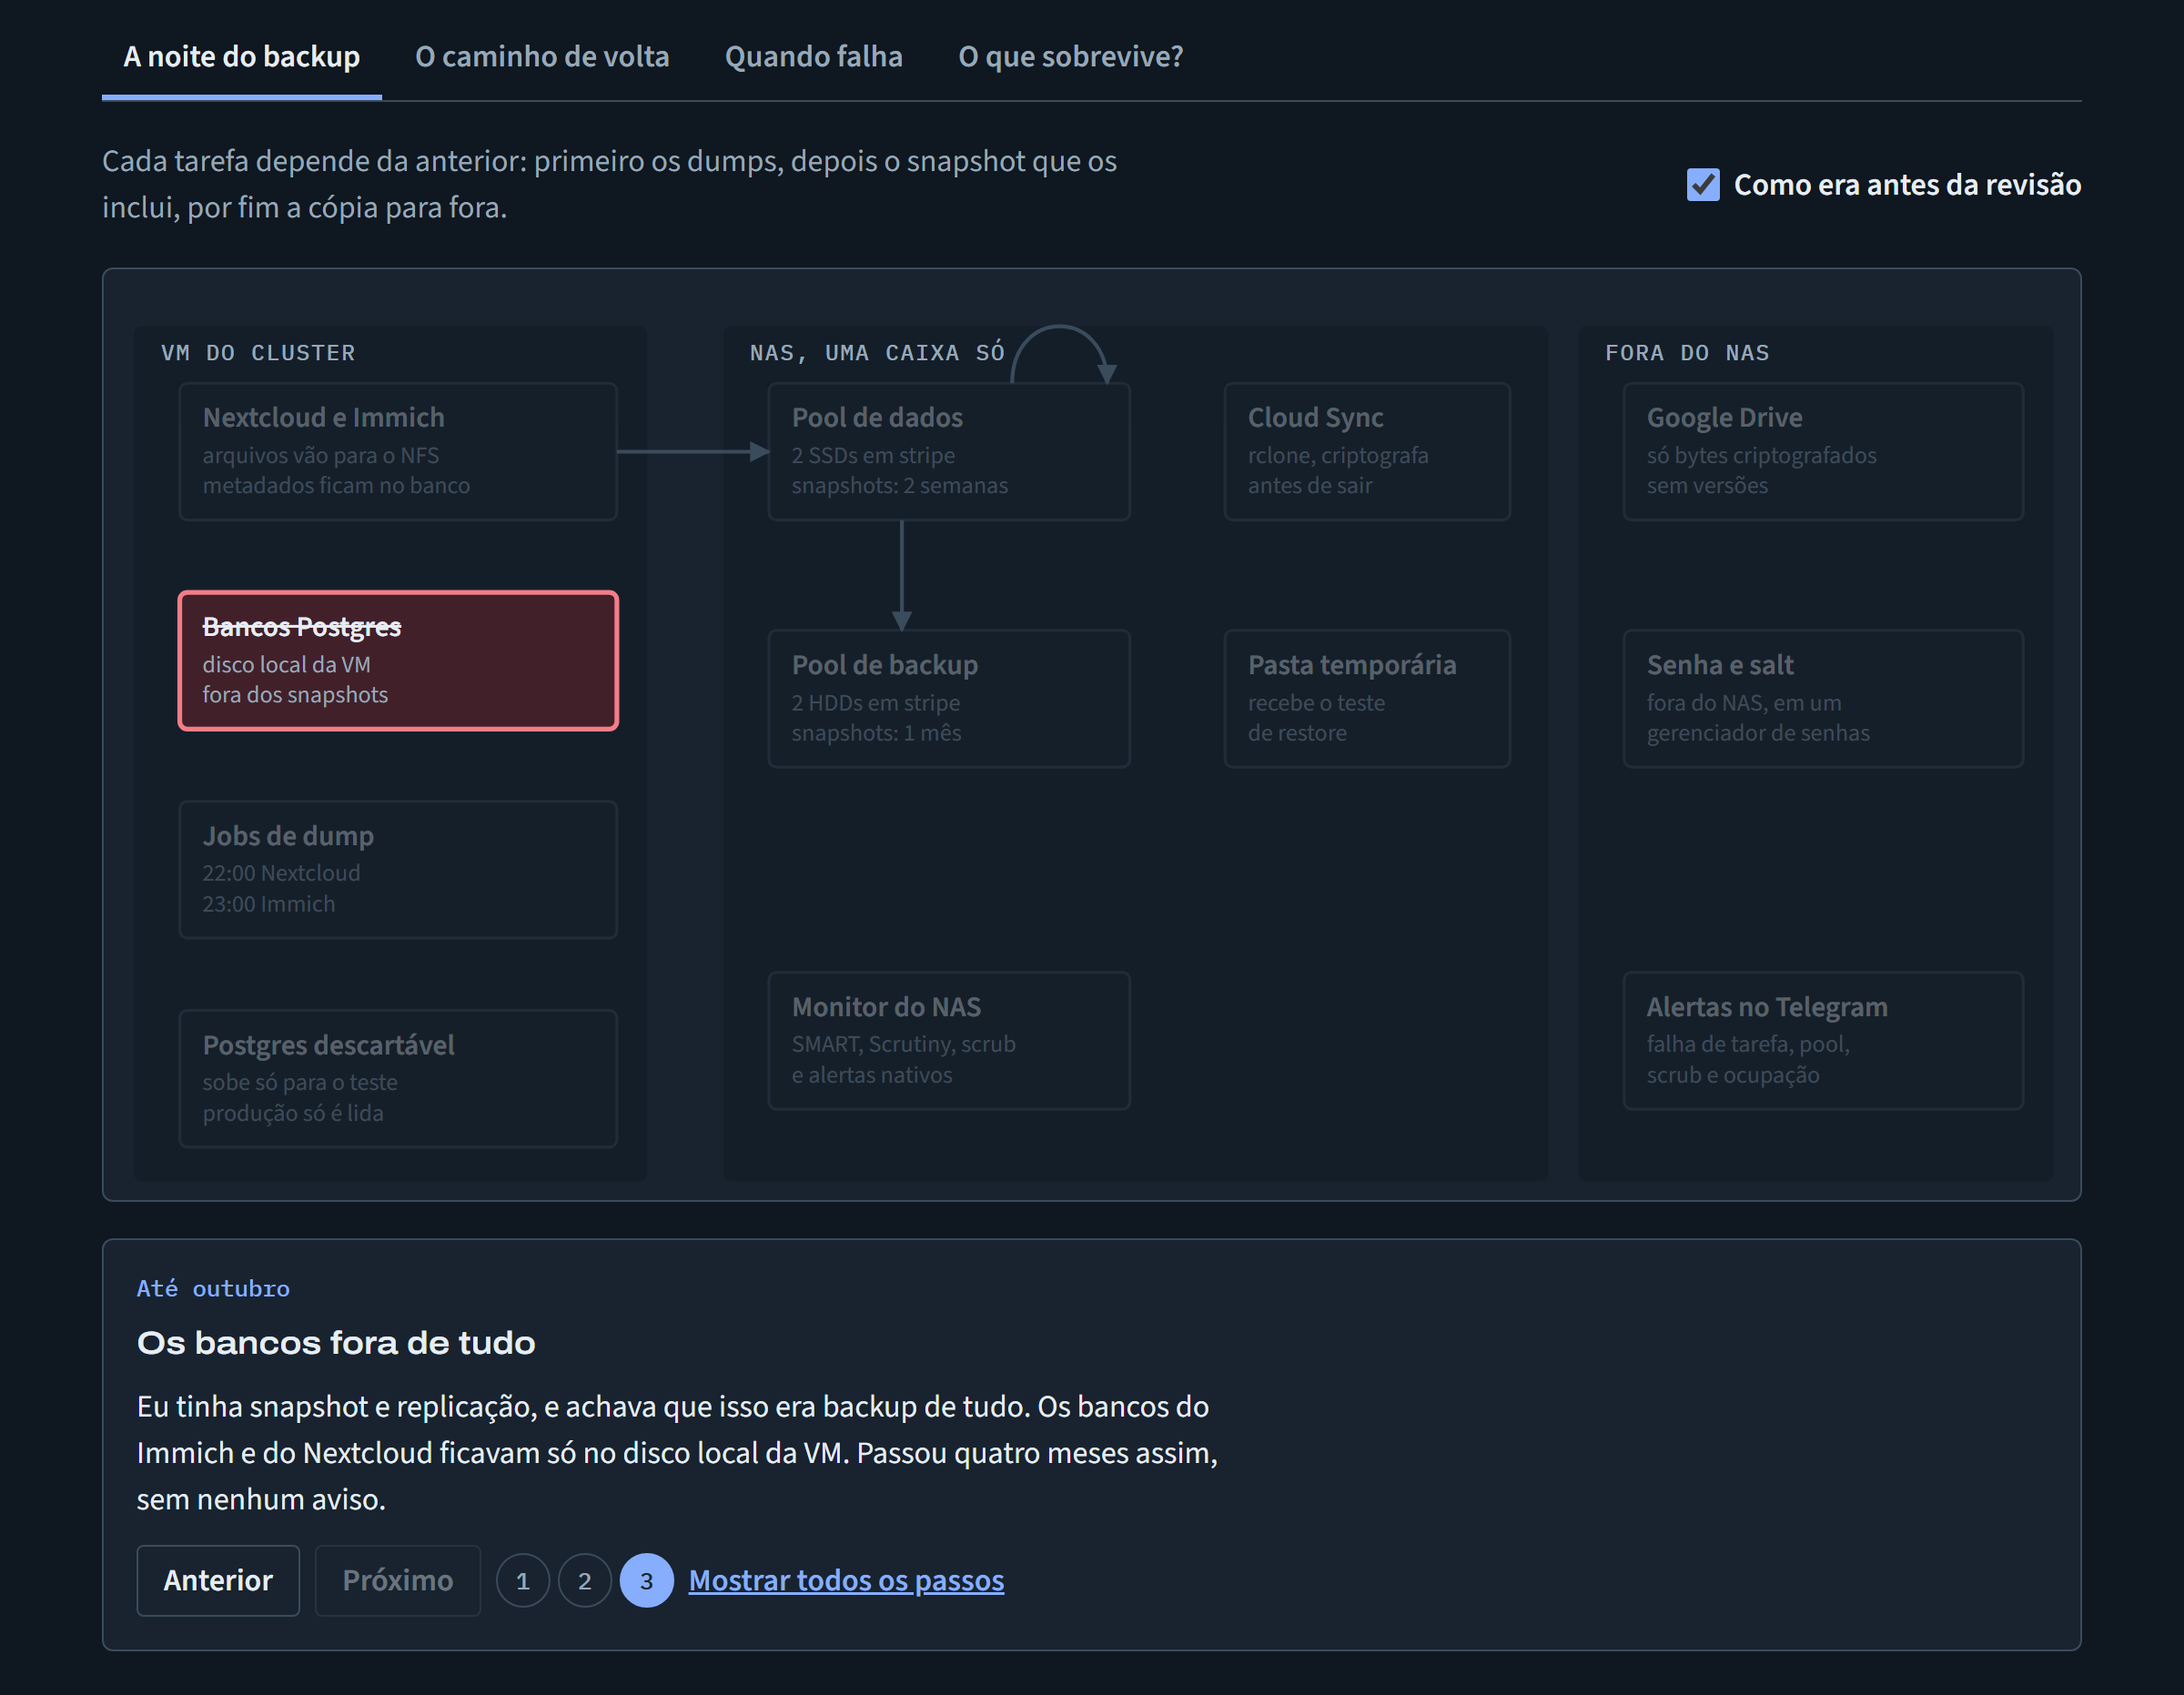
Eu tinha snapshot diário no ZFS e replicação entre os dois pools do NAS. Só que os bancos do Immich e do Nextcloud ficam em disco local da VM, fora do NAS. E os dois pools ficam na mesma caixa, então uma fonte queimada, um raio ou um ransomware levam tudo junto.
Eram dois problemas: banco fora do backup e nenhuma cópia fora de casa.
Dump antes do snapshot
Os clusters do CloudNativePG rodam em local-path, no disco do SO. A solução “certa” seria o Barman mandando pra um S3, mas eu não queria subir um S3 só pra isso agora. Fui no simples: um dump diário gravado no NFS, antes do snapshot da meia-noite. Assim o dump herda a proteção que já existia.
| Banco | Como | Horário | Mantém |
|---|---|---|---|
| Immich | Backup nativo do Immich | 23:00 | 14 arquivos |
| Nextcloud | CronJob com pg_dump -Fc |
22:00 | 14 dias |
O CronJob do Nextcloud grava primeiro num .tmp, valida e só então renomeia. Um dump pela metade nunca fica parecendo um dump bom:
set -eu
f="/dumps/nextcloud-$(date -u +%Y%m%dT%H%M%SZ).dump"
pg_dump -Fc -f "$f.tmp"
pg_restore --list "$f.tmp" > /dev/null
mv "$f.tmp" "$f"
find /dumps -name 'nextcloud-*.dump' -mtime +14 -delete
No caminho descobri que tinha três relógios no mesmo fluxo. O container do Immich em UTC, o CronJob em America/Sao_Paulo e o TrueNAS em PDT, o padrão da instalação. Meu “snapshot da meia-noite” rodava às 04:00 de Brasília. Ajustei o fuso do TrueNAS e passei a usar UTC explícito no nome do arquivo, porque o timeZone do CronJob só decide quando ele roda. O relógio dentro do container continua em UTC.
O restore que falhou duas vezes
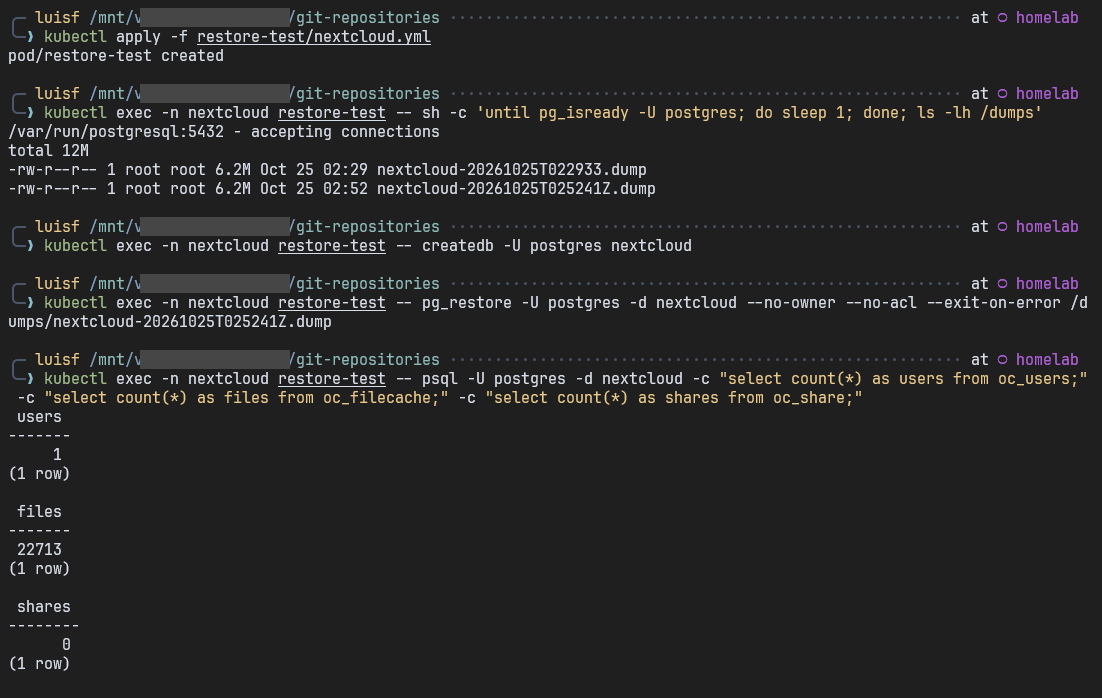
Pra testar, subi um Postgres descartável num pod, com o NFS dos dumps montado só pra leitura. Restauro, comparo as contagens com a produção e apago o pod. A produção só é lida.
O Nextcloud passou de primeira. O Immich falhou duas vezes.
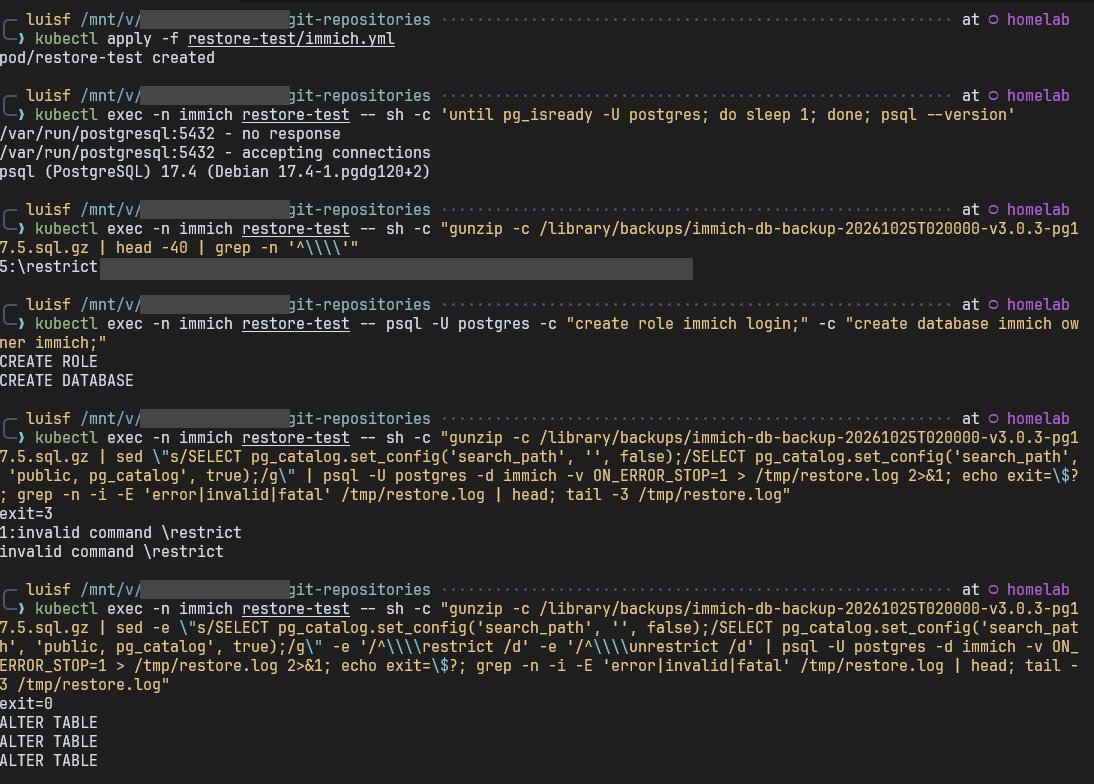
Na primeira, as tabelas foram parar no banco postgres, com uns 95 erros de role "immich" does not exist. Eu tinha assumido que o dump era um pg_dumpall, que traz role e CREATE DATABASE. É um pg_dump só do banco, então a role e o banco precisam existir antes.
Na segunda, o psql parou logo no começo:
invalid command \restrictO pg_dump a partir da 17.6 grava \restrict e \unrestrict no arquivo, e o psql 17.4 e 17.5 não conhece esses comandos. A imagem do meu próprio cluster tem psql 17.5, então isso me pegaria num desastre de verdade. Como o dump é meu, tirei as duas linhas com sed.
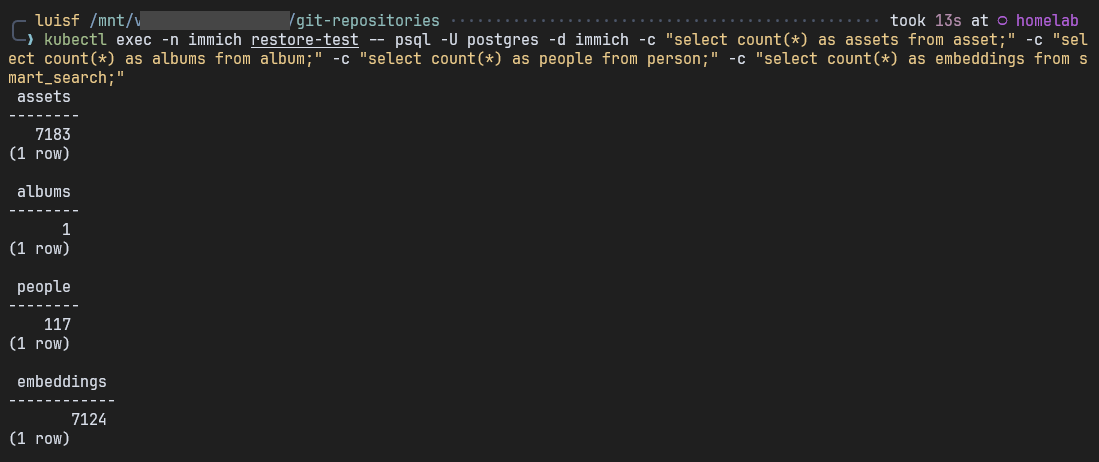
Com as duas correções, o restore terminou com exit=0 e as contagens bateram: 7183 assets, 117 pessoas e 7124 embeddings. Os embeddings iguais mostram que os vetores da busca voltaram também.
O procedimento foi pra um runbook, com um aviso honesto: o restore de desastre, no cluster real, ainda não foi exercitado de ponta a ponta. O que testei foi o dump.
A cópia fora de casa
Já pago 5TB de Google Drive, então fui por ali, com uma condição: criptografia antes de sair de casa. O TrueNAS tem Cloud Sync, que usa rclone por baixo. São três tasks (nextcloud, immich e db-dumps), com Remote Encryption e Filename Encryption.
O Google ainda vê quantidade, tamanho e horário dos arquivos. Não vê conteúdo nem nomes. Aceitei essa troca por enquanto. Mais pra frente, quero uma caixa na casa de alguém da família recebendo replicação ZFS criptografada, e aí o terceiro sai da história.
O modo é COPY, nunca SYNC. O SYNC espelha a origem: um arquivo apagado por engano, ou por um ransomware, some do backup também. Com o COPY, uma exclusão aqui não apaga nada lá, o que também me protege num cenário de ransomware.
Senha e salt ficam no Bitwarden e no papel. Sem eles, o que está no Drive é lixo. Na mesma nota deixei como restaurar sem o TrueNAS, já que é rclone crypt por baixo. O código de recuperação do 2FA do Bitwarden também foi pro papel, senão eu criaria uma dependência circular.
A primeira subida ensinou que o gargalo não era a internet. O Immich, com uns 16 mil arquivos e 8,9GiB, levou 11h30 a 190KiB/s, porque o Drive limita quantos arquivos dá pra criar por segundo. O Nextcloud levou mais de dois dias, com 81606 arquivos e 96,2GiB.
A task que falhava toda noite
Aí veio a primeira execução agendada do Nextcloud:
[EFAULT] ... rateLimitExceededForam mais de 9 horas, os arquivos subiram e mesmo assim terminou como FAILED. Os erros eram de listagem e de data de pasta. A cota era de requisições, não de espaço, e requisição cresce com a quantidade de pastas. Fui contar:
| Arquivos | Pastas | |
|---|---|---|
| Total | ~88 mil | 40828 |
| Previews do Nextcloud | 12169 | 33452 |
Previews eram 14% dos arquivos e 82% das pastas, e o Nextcloud gera tudo de novo. Coloquei no Exclude, junto com node_modules:
/data/appdata_*/preview/**
node_modules/**
O Dry Run ficou lindo:
Sem Exclude |
Com Exclude |
|
|---|---|---|
| Arquivos comparados | 88997 | 56614 |
| Itens listados | 258713 | 123181 |
| Tempo | 1h33 | 8m47 |
Achei que estava resolvido, só que Dry Run não faz escrita, e estava escrito no próprio log: Skipped set directory modification time.
57GiB que não deviam subir
O Dry Run dizia 187 arquivos pra enviar. Rodei de verdade e a tela mostrou outra coisa:
122 / 7211, 1.272 GiB / 57.468 GiB, 2.920 MiB/s, ETA 5h28m27sAí começou a caça. A primeira suspeita foi a lixeira, porque arquivo restaurado muda de caminho. Um find por ctime mostrou só 4 arquivos alterados desde o Dry Run. Depois vi no log Copied (new) em fotos de 2023 que já estavam no Drive, abortei e fui olhar senha e salt. Nenhum erro de decrypt. Pastas duplicadas no Drive? Zero Duplicate no log.
Três hipóteses erradas, e a resposta estava num grep ' ERROR ':
ERROR : .../+photos/pixel-7: error reading destination directory: couldn't list directory: googleapi: Error 403: Quota ...A pasta de fotos do meu celular tem 7154 arquivos e 57GiB, exatamente o que apareceu na tela. A cota estourou, a listagem daquela pasta no Drive falhou e o rclone jogou a pasta inteira na fila como nova. Ou seja, o rate limit não era só um erro no fim da execução: ele podia gerar reenvios gigantes. Subiram pelo menos 268 arquivos antes de eu abortar, que devem ter ficado repetidos no Drive.
O erro tinha aparecido menos de dois minutos depois do início, mesmo com o Exclude. O limite estourado era de 240 mil requisições por minuto, por projeto. Uma NAS sozinha dificilmente chega nisso, então o mais provável é que o projeto OAuth seja compartilhado com mais gente. Não confirmei de quem é.
Um OAuth só meu
A saída foi criar um projeto meu no Google Cloud, sem custo: Drive API ligada, cliente do tipo Desktop app e escopo drive, porque o drive.file não enxergaria o que já estava lá. O token saiu do rclone no meu PC:
rclone authorize "drive" "CLIENT_ID" "CLIENT_SECRET"Tomei um 403: access_denied porque o app ainda estava em Testing. Dava pra me adicionar como testador, mas em Testing o token expira em 7 dias, e o backup voltaria a falhar uma semana depois. Publiquei o app, o que exigiu preencher a página de branding com página inicial e política de privacidade. Ele fica como “não verificado”, o que só gera um aviso no meu login.
Criei uma credencial nova no TrueNAS, sem mexer na antiga, e testei só na task do Nextcloud:
| Execução real | Antes | Com OAuth próprio |
|---|---|---|
Error 403 |
várias, em menos de 2 minutos | 0 |
| Falha de listagem | 6 pastas | 0 |
| O que subiu | fila de 57GiB | 124 arquivos novos |
Senha, salt e arquivos no Drive continuaram iguais, e depois migrei as outras duas tasks. Na madrugada seguinte, a execução agendada levou 8 minutos, contra mais de 9 horas antes, e terminou sem nenhum 403.
O log de 700MB
O que ainda faltava subir era quase só o nextcloud.log, com 622MiB e crescendo. Fui olhar por quê e achei isto na tela de background jobs:
Some jobs have not been executed since 4 months ago.O Nextcloud estava em modo AJAX, em que os jobs só rodam quando alguém abre a interface web. Sem ninguém abrindo a interface, quase nada disparava. Foi uma linha no chart, com limites pra não sobrar pra interface:
cronjob:
  enabled: true
  resources:
    requests:
      cpu: 50m
      memory: 128Mi
    limits:
      cpu: 500m
      memory: 1Gi
O pod voltou como 2/2, e o sidecar foi direto pra 461m de CPU, mastigando quatro meses de atraso.
O primeiro restore do Drive
Tudo isso ainda não provava que o backup volta. Criei uma task PULL pra uma pasta temporária, trazendo os dumps do banco, e digitei senha e salt do Bitwarden à mão. Se eu usasse o botão Restore da task, poderia reaproveitar o que já está salvo nela, e o teste não provaria a cópia guardada fora do NAS.
cmp -s "$f" "/mnt/data-ssd/db-dumps/$f" && echo "IGUAL $f" || echo "DIFERENTE $f"Os 12 dumps voltaram com nomes legíveis e iguais byte a byte aos originais. Isso prova o caminho Drive, criptografia, senha e salt. Não testei as tasks do Immich e do Nextcloud, e por enquanto fico satisfeito com isso.
Aproveitei e reduzi a retenção da replicação pro backup-hdd de 3 meses pra 1 mês. Não preciso de mais que isso.
Desenhei tudo pra conferir
Quando entrei num time novo no trabalho, a arquitetura era grande e a documentação explicava bem cada peça, mas eu não conseguia ver o caminho de uma mensagem passando por várias delas. Parei de tentar decorar e comecei a desenhar. Virou um mapa interativo que o time gostou. Esse eu não posso mostrar, mas o método eu posso, e com a revisão fechada resolvi testá-lo em casa, no sistema que eu achava que conhecia.
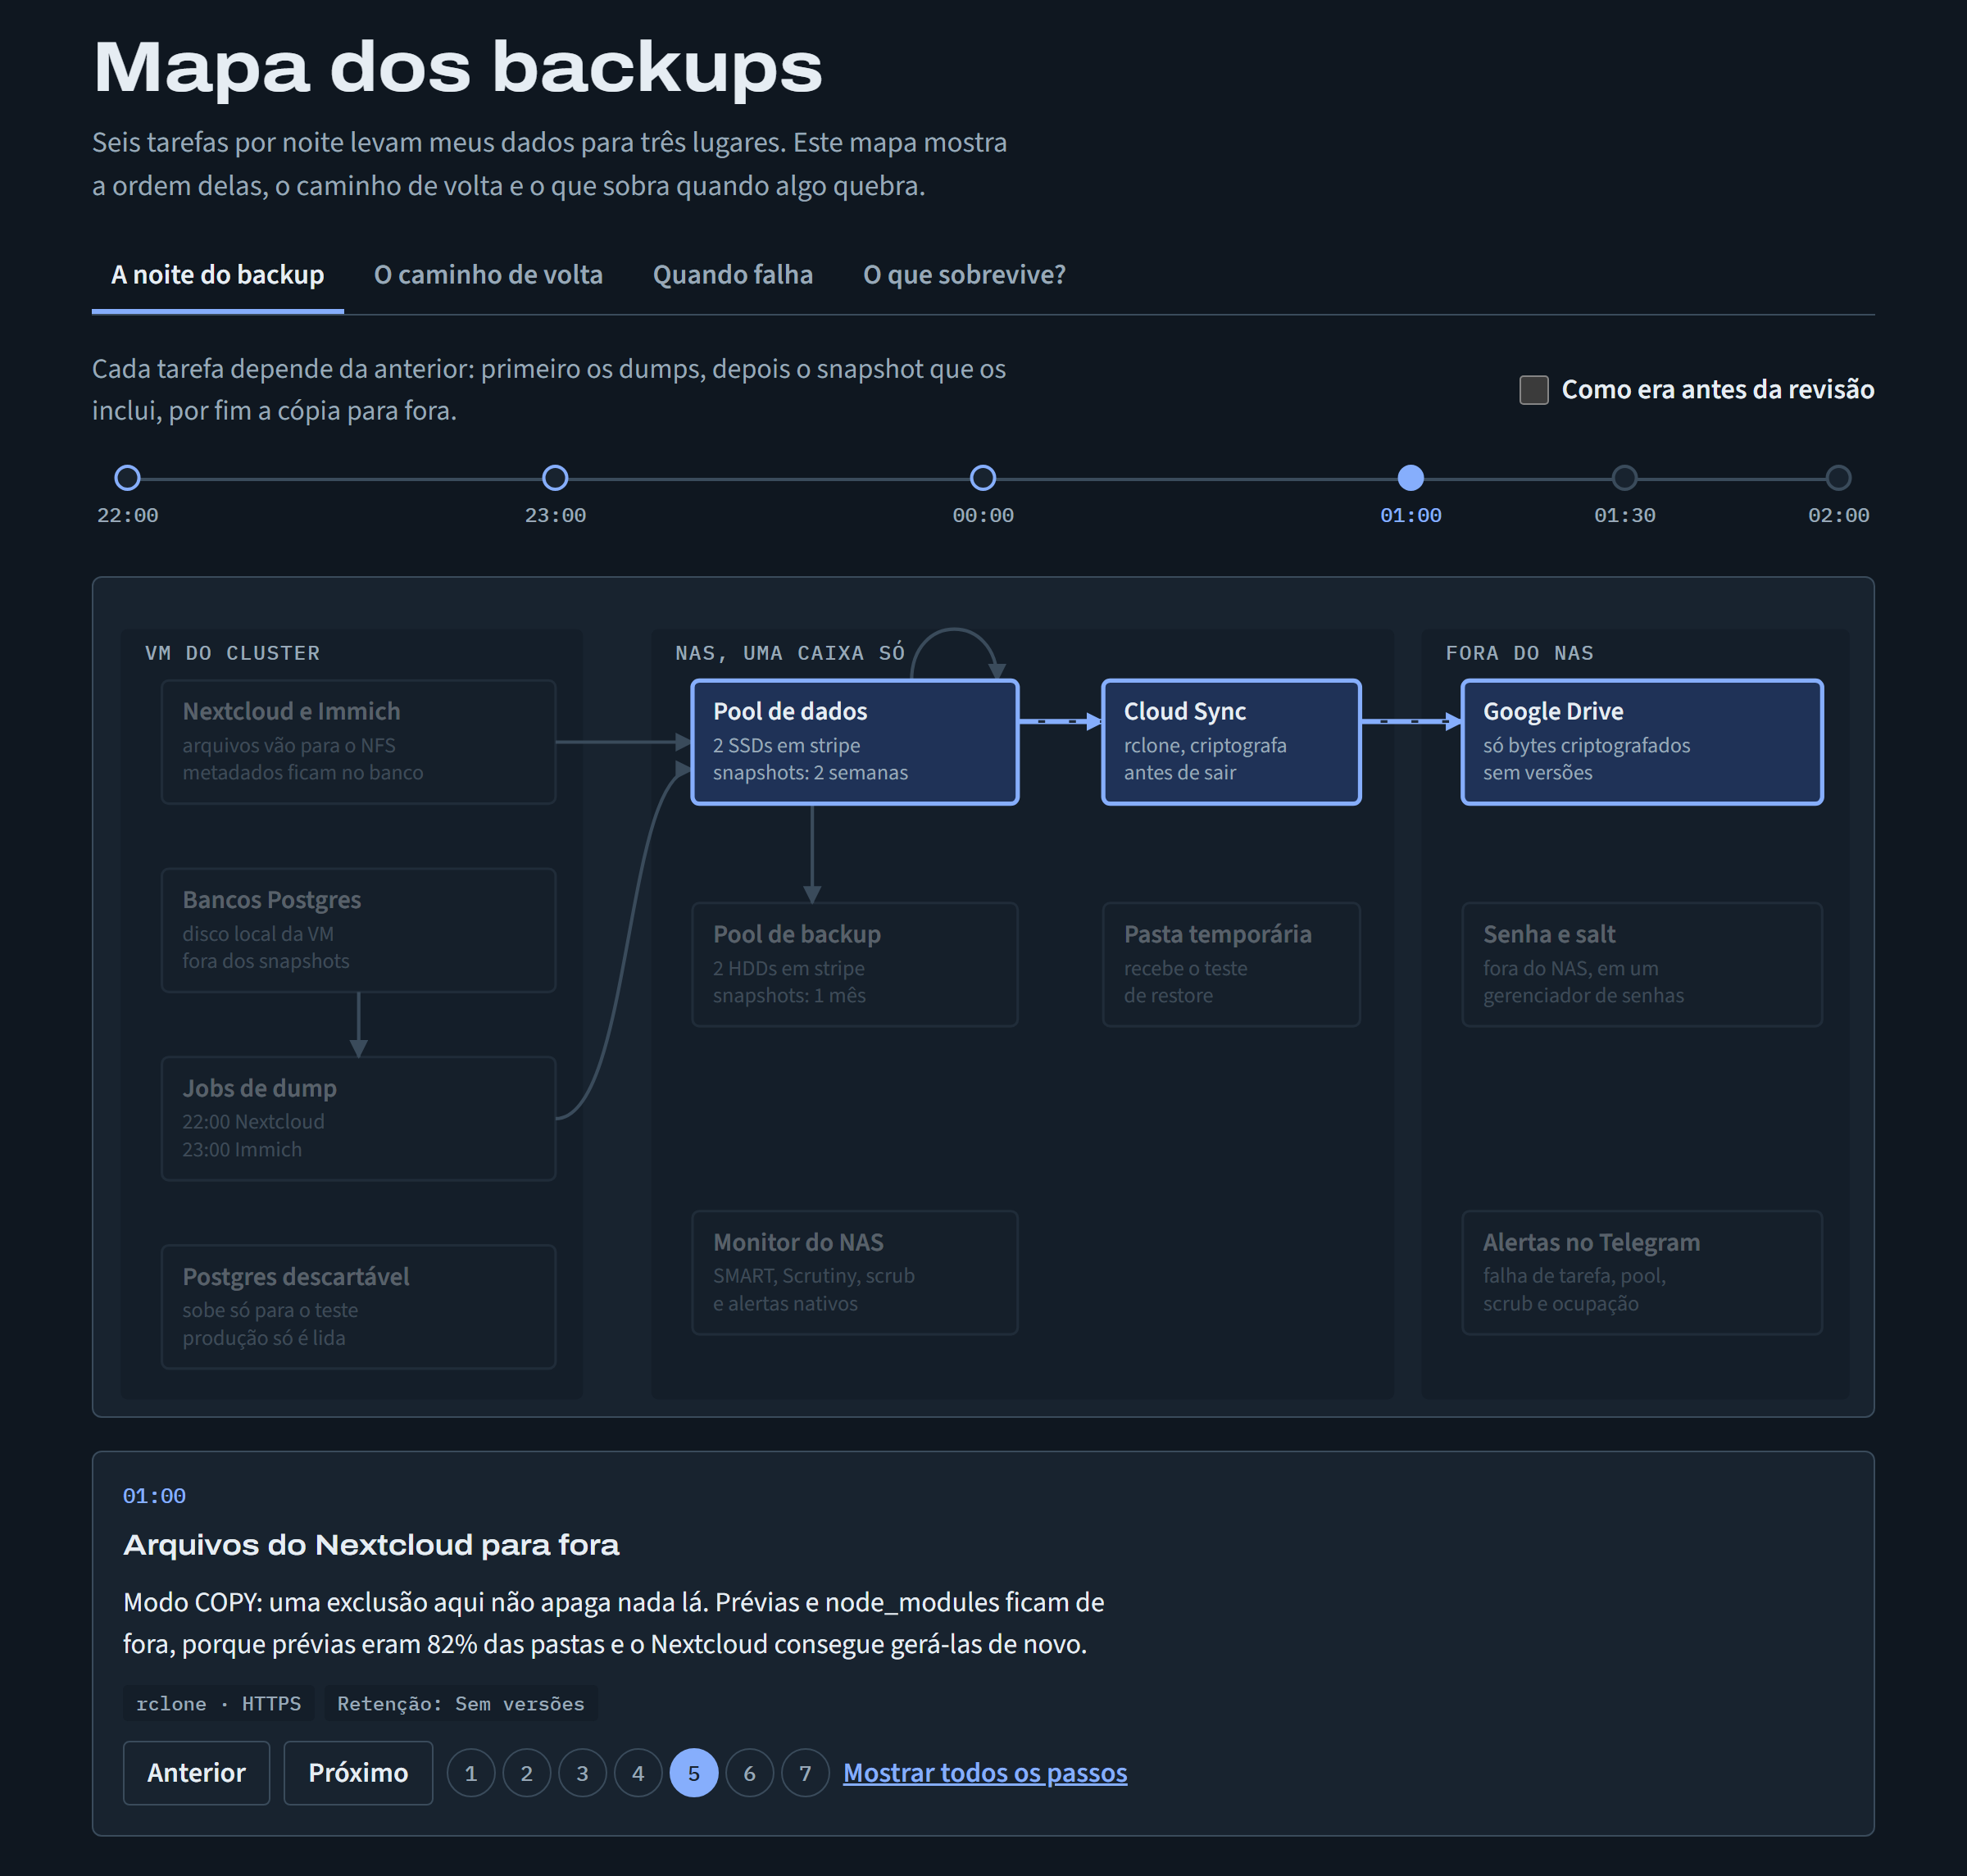
Desenhar obriga a responder o que a leitura deixa passar. Pra traçar uma seta, preciso saber quem chama quem, em que ordem e o que volta. Não dá pra escrever “está coberto” numa seta. O mapa fica sempre visível, com um passo por vez, e o detalhe só aparece quando alguém clica.
São quatro abas. A primeira é a noite do backup, com a linha do tempo em escala e um botão que mostra como era antes da revisão. Tudo o que contei lá em cima cabe nessa imagem: o snapshot às 04:00, as duas cópias na mesma caixa e os bancos numa caixa sem nenhuma seta saindo dela. Numa tabela, isso é uma linha que falta. No desenho, salta aos olhos.
Três linhas tracejadas
A aba do caminho de volta é a que justifica o projeto. As linhas cheias são restores que já fiz. As tracejadas existem no plano, mas nunca foram testadas.
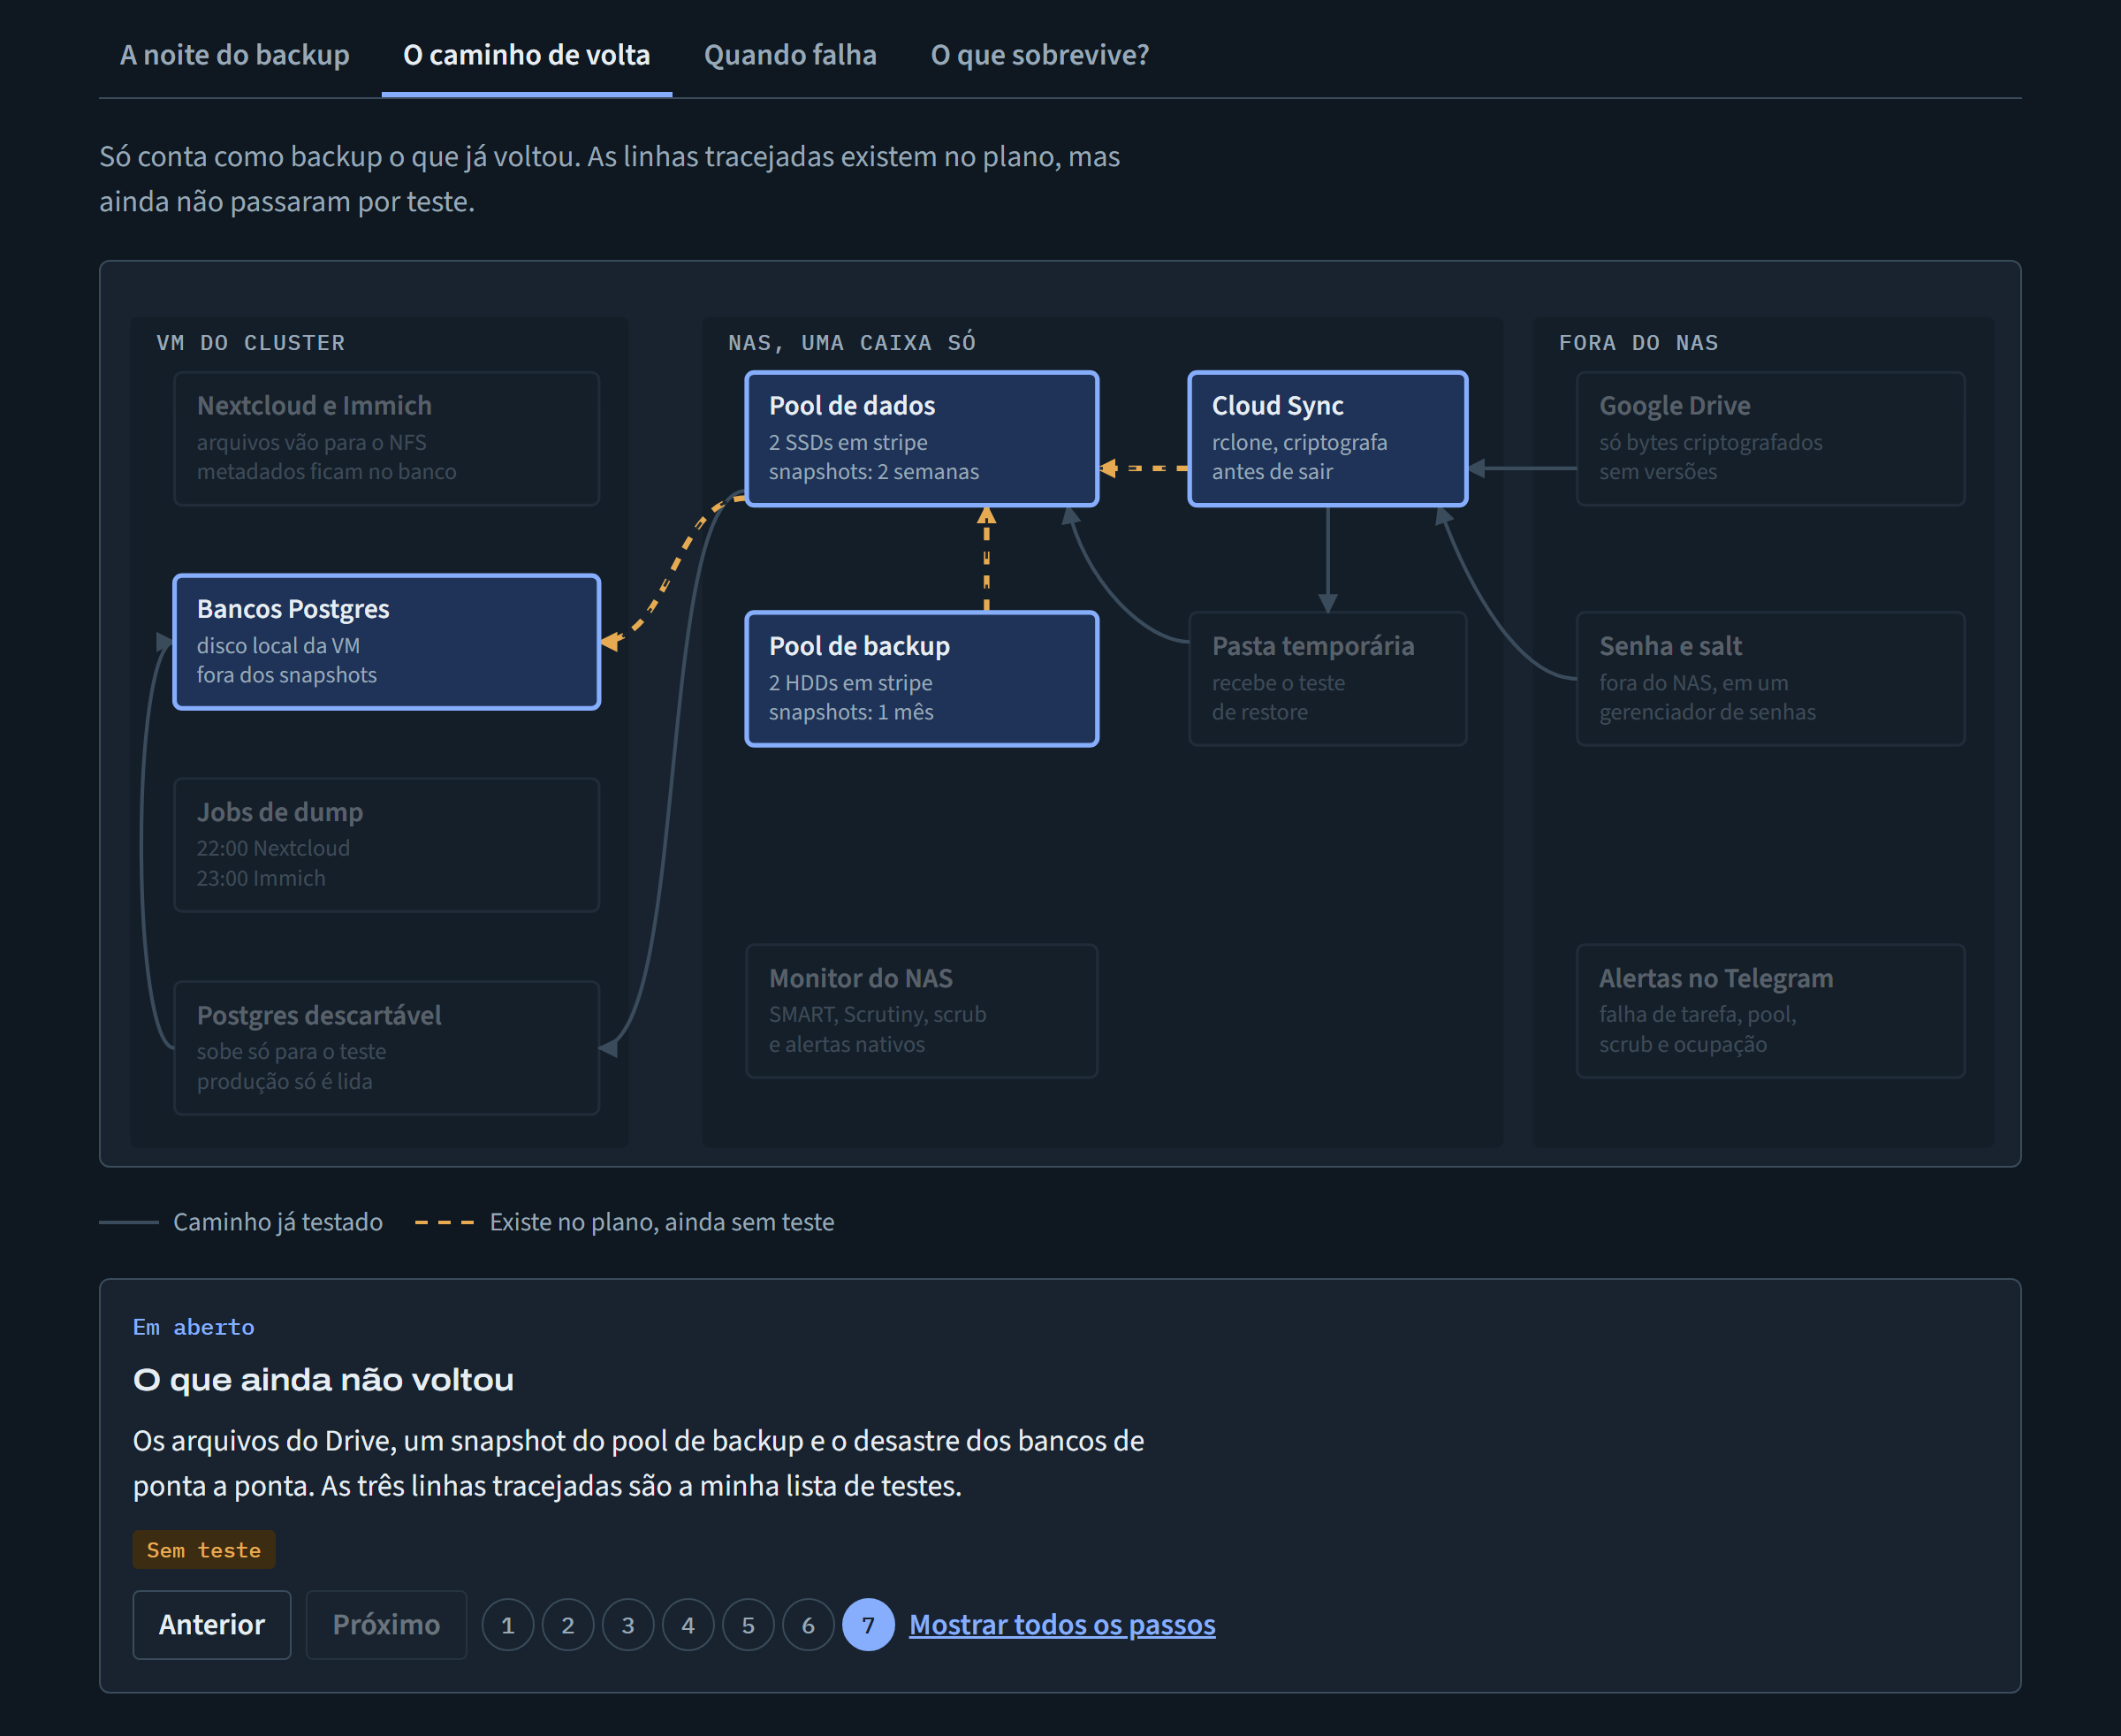
São três: os arquivos do Drive, um snapshot do pool de backup e o desastre dos bancos de ponta a ponta. Eu sabia que eram pendências. Vê-las desenhadas é diferente, porque o caminho com que eu mais conto numa perda total é justamente o que tem menos prova.
A aba de falhas mostrou outro buraco. Replicação, Cloud Sync e discos mandam alerta no Telegram. Um dump que falha fica registrado como Job falho e não avisa ninguém.
O que sobrevive?
A última aba é um simulador simples. Escolho o que quebrou (um SSD, a caixa inteira, a VM, as chaves) e o mapa pinta o que sobrevive, o que se perde e como eu voltaria. Cada cenário termina dizendo o que daquele caminho já foi testado. É raciocínio, não simulação de desastre, e a página avisa isso.
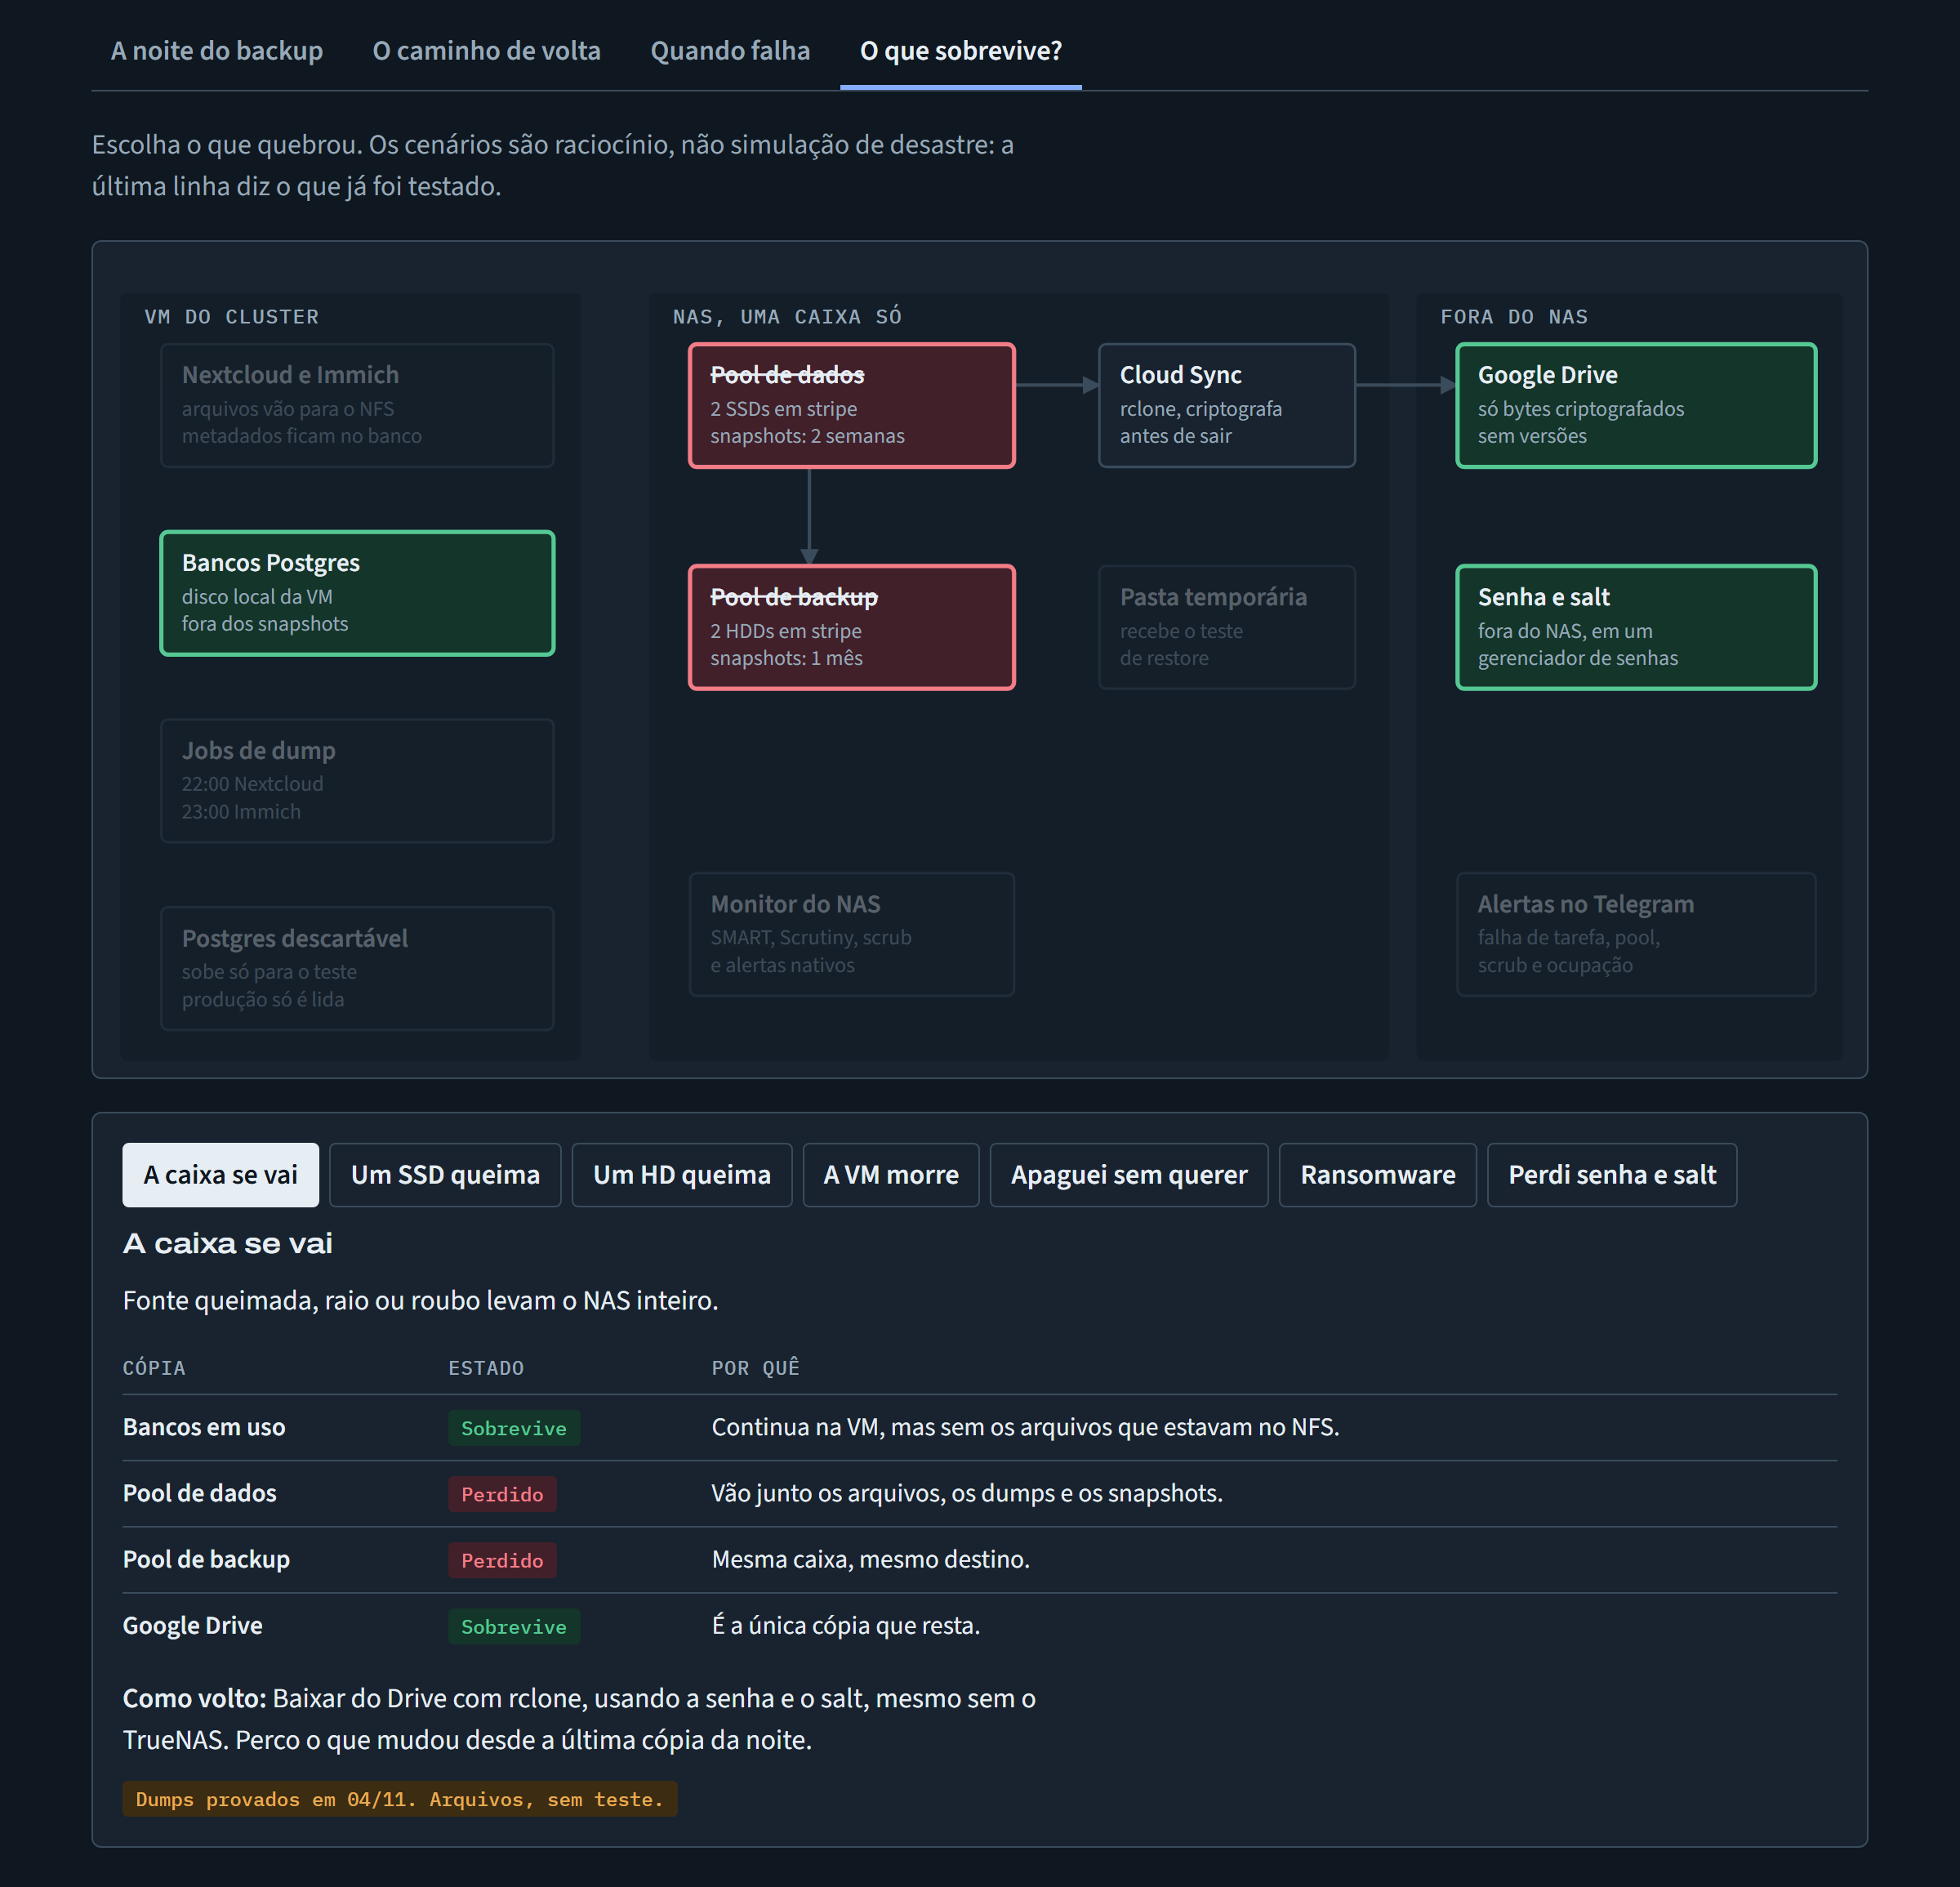
Sobre a IA, a mesma ressalva dos dois mapas: ela acelera a coleta e a construção da página, mas não sabe o que mudou no sistema nem o que eu nunca testei. Um diagrama bonito passa uma segurança que nem sempre merece, por isso os estados de “sem teste” ficam na tela.
O que ficou aberto
As linhas tracejadas viraram a minha lista de testes. A próxima é trazer uma amostra dos arquivos de volta do Drive, depois um snapshot do pool de backup e, em algum momento, o restore de desastre no cluster real. Junto vão o alerta pra dump que falha, ver o log do Nextcloud ser rotacionado e limpar os arquivos repetidos no Drive. Quando uma linha ficar cheia, atualizo o mapa.
Se quiser fazer o seu, escolha um fluxo que você acha que entende e desenhe até travar. O ponto em que a seta não tem pra onde ir é a sua próxima pergunta.